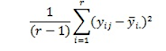Sunday, April 10, 2016

Questões de amostragem


Definições


População ou universo é conjunto de unidades sobre o qual desejamos  informação.

Amostra é subconjunto de unidades retiradas da população para obter a informação desejada.

Censo é o levantamento de dados de toda a população.

Amostragem é o levantamento de dados de parte da população para obter a informação desejada.

    Parâmetro representa determinada característica da população. Em uma dada população e em dado momento, o parâmetro não varia,  é um valor fixo. Em geral, o parâmetro é desconhecido (e, portanto, precisa ser estimado).

      Estatística é uma quantidade calculada com os dados de uma amostra. É usada para estimar o parâmetro correspondente da população de onde foi retirada.

 Erro de amostragem é a diferença entre a estatística obtida da amostra e o parâmetro que se quer estimar.


Exemplo


Veja aqui o exemplo de uma população fictícia muito pequena, isto é, de quatro unidades, da qual ninguém pensaria em tomar uma amostra aleatória de duas unidades para estimar uma estatística. Não teria sentido, nem para o estatístico, nem para o pesquisador.


Mas como simples exemplo didático, ajuda a entender as definições dadas. Além disso, o procedimento para tomar amostras seria o mesmo, caso tivéssemos uma população de 30.000 pessoas para dela tirar amostras de 100.


Imagine então que quatro alunos, de mesma idade e da mesma série, fizeram a mesma prova. Esses alunos serão considerados como população e as notas como dados observados dessa população. As notas e a média das quatro notas (que é a média da população) estão na tabela abaixo.


                                                  Notas dos alunos


Nome

Nota

João

10

José

6

Paulo

4

Pedro

0

Média

5


Vamos agora expor todas as amostras possíveis de tamanho dois com reposição, com as respectivas médias e a média dessas médias. Por que amostra com reposição? Porque na vida real, se alguém quiser tomar uma amostra de dois alunos, toma uma e uma só amostra.


                         Média das notas para a respectiva amostra


Amostra

Média

João e José

8

João e Paulo

7

João e Pedro

5

José e Paulo

5

José e Pedro

3

Paulo e Pedro

2

Média das amostras

5


 A média das médias das amostras é 5, que é a mesma média da população. Isto NÃO é coincidência. Se, de uma população finita, você tirar todas as amostras possíveis de tamanho n, a média dessas amostras será igual à média da população. Daí a importância que se dá, em ciência, da repetição das pesquisas em iguais condições. Isso permite que se possa, posteriormente, agrupar todas as pesquisas feitas nas mesmas condições em uma análise conjunta (meta análise) e obter assim melhor informação.


Com uma única amostra, é possível obter o parâmetro? Não, o que se obtém é uma estimativa. As estimativas têm erros – e é possível estimar as margens de erro das estimativas dos parâmetros. Por ora, vamos ver os erros de amostragem. Veja a tabela.


                                    Erros das médias das amostras


Amostra

Média

Erro

João e José

8

8-5=3

João e Paulo

7

7-5=2

João e Pedro

5

5-5=0

José e Paulo

5

5-5=0

José e Pedro

3

3-5=-2

Paulo e Pedro

2

2-5=-3

Média

5

0


 A média dos erros de amostragem é zero, o que NÃO ocorreu por acaso. Se, de uma população finita, você tirar todas as amostras possíveis de tamanho n, a média dos erros de amostragem será igual a zero. E existe ainda outra propriedade, do qual essa decorre: os erros se distribuem em torno da média zero.


 Este exemplo fictício e extremante simples ajuda a entender definições. Mas como é a amostragem na vida real? Pesquisadores não têm acesso a toda a população. Mais ainda, pesquisadores de áreas técnicas só têm acesso às unidades com as quais trabalha.


Exemplo


O trabalho é antigo1, mas perfeito para nosso exemplo. Pesquisadores queriam verificar se o hábito de tomar café em excesso é fator predisponente para câncer de pâncreas. É obvio que os pesquisadores só poderiam trabalhar com as pessoas que tivessem acesso. É o chamamos de amostra não probabilística. Mas precisavam medir a variável “proporção de pessoas que tomam café em excesso” em duas populações: a de doentes (câncer de pâncreas) e a de não doentes, para comparação.


Os pesquisadores optaram por um estudo retrospectivo, caso-controle. Mas antes de começar a recrutar pacientes, precisavam detalhar os critérios de inclusão, lembrando que os participantes da pesquisa deveriam responder um questionário. Foram consideradas elegíveis pessoas com menos de 80 anos, brancas, residentes nos Estados Unidos da América, que não tivessem dificuldades de linguagem e não estivessem muito doentes.


  Mas onde achar pessoas com a doença para formar um grupo? Os pesquisadores buscaram pessoas com a doença nos quatro hospitais onde trabalhavam. Foram identificados 598 casos de câncer de pâncreas. Desses 598 casos, 112, ou seja, 18,7% não atingiam os critérios de elegibilidade; ainda, 20 já haviam morrido e 35 tinham tido alta. Dos que estavam hospitalizados, 26 se recusaram a participar da pesquisa.  Então a pesquisa começou com 405 participantes. No entanto, respondidos os questionários, os pesquisadores ainda descartaram 16 respondentes, por não os considerar confiáveis.


Portanto, da amostra configurada de 598 possíveis pacientes que os pesquisadores pretendiam acessar, apenas 389 participaram efetivamente da pesquisa, ou seja, 65%. Como o estudo foi planejado para ser caso-controle, obtidas as respostas dos 389 casos, foi preciso buscar controles, em tudo similares aos casos, exceto pelo fato de não ter a doença. Formou-se, assim, uma amostra não probabilística para estudo de caso-controle.


         Referência

           1. MacMahon, B et allii.  Coffee and cancer of the pancreas.
                      The New England of Medicine, March 12, 1981. 


Sunday, March 27, 2016

Desvios padrão não se somam. Por que?

Uma doutoranda da Unicamp, que não conheço pessoalmente, me apontou gentilmente, por e-mail, o que ela considerou um “pequeno erro de cálculo” em meu livro, Análise de variância: o resultado do coeficiente de variação (CV), que consta na página 47, estaria errado. Claro, busquei rapidamente o texto e me pus na frente do computador.


Mas vamos ao que está no livro: é dado um exemplo fictício de experimento com dois tratamentos, A e B, e cinco repetições por tratamento. Os dados são poucos porque têm a finalidade única de mostrar como se fazem os cálculos. Veja a tabela de dados e a tabela de análise de variância.


                             Dados obtidos em um experimento


Tabela de análise de variância


Em qualidade, não é usual proceder a uma análise de variância. Calculam-se médias, desvios padrões, gráficos de controle. Então a doutoranda, que é da área de qualidade, calculou, como sempre fez, as médias e os desvios padrões do exemplo dado. Obteve:


Médias e desvios padrões segundo os tratamentos

Está tudo bem até aqui. Mas depois, estudando no meu livro Análise de variância, a doutoranda leu: Pode existir interesse em relacionar o desvio padrão com a média, para se ter ideia da grandeza da dispersão em relação à grandeza da média. Por definição, coeficiente de variação, que se indica por CV, é a razão entre o desvio padrão e a média dos dados, isto é

Havia, também, esta informação: na análise de variância, o desvio padrão é dado pela raiz quadrada do quadrado médio do resíduo. Reconheço que o que está escrito no livro não é suficiente para esclarecer um aluno. De qualquer forma, ali está apresentado o valor correto para do coeficiente de variação para o exemplo dado acima:

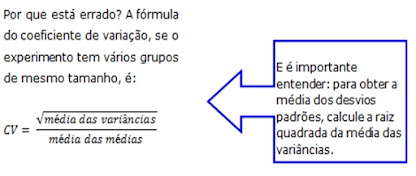
Mas vamos aos fatos. A análise de variância não é técnica comum entre pesquisadores da área de qualidade. Então a doutoranda NÃO tinha o cálculo do quadrado médio do resíduo (QMR). O coeficiente de variação foi calculado fazendo a média das médias e a média dos desvios padrões, com base nos resultados apresentados na tabela de médias e desvios padrões. Está errado:


Para explicar isso, resolvi recorrer ao Dr. Math (Doctor Schwa, The Math Forum http://mathforum.org/dr.math/) e apresentar um pouco de matemática.


       Vamos voltar ao coeficiente de variação. Na tabela apresentada anteriormente, de médias e desvios padrões, deveriam ter sido apresentadas as variâncias de cada grupo, além de médias e os desvios padrões.


Médias, variâncias e desvios padrões segundo os tratamentos


Demorei muito para entender que a fórmula, como está na definição dada em meu livro, Análise de variância, e é a comumente apresentada nos livros didáticos de estatística, pode levar a erro. No livro está escrito:


Por definição, coeficiente de variação, que se indica por CV, é a razão entre o desvio padrão e a média dos dados, isto é

A fórmula está correta desde que em análise haja uma única variável em um só grupo. Nos experimentos ou ensaios completamente randômicos, uma variável é observada em k grupos. Se for calculada a média e o desvio padrão de cada grupo, o coeficiente de variação (geral) será dado pela divisão da raiz quadrada do quadrado médio do resíduo da análise de variância pela média geral. O quadrado médio do resíduo (QMR), desde que todos os grupos tenham r repetições, é

em que SQR é a soma de quadrados do resíduo, dada por


                Verifique que


 é a variância do i-ésimo tratamento e o QMR é a média das variâncias de cada grupo.


     Procure o livro em http://www.saraiva.com.br/

                 analise-de-variancia-anova-1100479.html


Thursday, March 24, 2016

What is research methodology? A notion for begginners

Broadly speaking, research can be done according to two methods identified as:

     a) Qualitative research

     b) Quantitative research


Qualitative research aims a better understanding of people´s behavior, their attitudes, their beliefs and their fears. Its goal is to gather information the way people understand the world in which we live and to the meaning they attribute to their own experiences. Data are collected by means of interviews, focus groups, observations, analysis of documents and speeches.


By the other hand, typical objective of quantitative research is to count, organize and measure in order to describe, explain and predict. Quantitative research gathers data in numerical form for estimating averages, standard errors, confidence levels and margins of errors, test hypothesis, find patterns of relations between variables.


Qualitative research can be done involving only a few people in order, for instance, to collect words or expressions that were used to describe feelings experienced in a given situation – such as a huge fire. Following this, a quantitative research should be done by organizing a questionnaire with the words or expressions collected during the qualitative research. These would then be applied to a large number of respondents to compare the statistical distribution of the feelings expressed by different groups, considering age, sex, social class.


As another example, the researcher who wants to study the subjective experience of a mental illness would have to interview several patients and make a detailed analysis of the facts. But to describe the frequency and distribution of the illness in the population, the quantitative researcher must collect data of a representative sample of the population, which means participants selected at random. It follows that the two research methods are neither opposed nor opponents; on the contrary, they are complementary.


In some fields, researchers get involved in actual battles in order to determine the “best” research method; but the right thing to do would be to study the strategies in parallel. Qualitative research, as the less structured method, is required when facing lesser known realities, but in fields where knowledge is deeper, quantitative research is indicated. Therefore, qualitative research should precede quantitative research.


But researchers are right when they say that there is no point in arguing over which of the two is the most adequate research method. A researcher chooses the method according to the question he/she intends to answer and completes every job always bearing in mind that a quantitative study may raise questions that need to be dealt with by the qualitative method, and vice-versa. Competence of the researcher and a well designed study count most.


Historically, qualitative researches are rejected in health fields of study because extremely small samples sizes; they are not repeatable neither reproducible, so there is a risk of bias. For this reason they are considered by some as soft science. Anyway, neither quantitative nor qualitative research method can provide the truth about everything.


Let us give some examples where both methods qualitative and quantitative, can be used. Usually, research on voter´s intentions is done using the quantitative method. The researcher asks a large number of people the following question, “If the election was today, who would you vote for?”The percentage of votes for each candidate is then calculated, with margins of error at a level of significance. Then the research can declare quite confidently, “If the election was today, X would probably win.


On the occasion of election previews, the importance of qualitative research is much commented upon. In this kind of research, the interviewer would ask people, for example, “What qualities should a President of the Republic have?” or “What are the country´s main problems?” and afterwards he or she would analyse the answers.


As another example: in order to find the answer to the query “Taking into account sex and age groups, what proportion of smokers has already attempted to stop smoking?” quantitative research would be needed. The researcher invites people to reply to a questionnaire. Then he/she calculates the percentages per sex and age group and makes generalizations within a certain margin of error. This is quantitative research.


But to find out what prevents people from giving up smoking, qualitative research is required. The researcher would first ask the question “Why don´t you stop smoking?” Then, he/she would have a long conversation with each member of a small group trying to bring up reasons and opinions. Further analysis of data is fundamental.


As a final example, to find out what people understand by the legalization of drugs, the researcher would engage in qualitative research, interviewing a few individuals (about 20).To discover the percentage of individuals who are favorable to the legalization of drugs, and the distribution of this percentage by sex, age group, education level, social and economic levels, and region, the researcher would engage in quantitative research, interviewing many people (around 2000)


Wednesday, March 23, 2016

Tamanho da amostra para comparar clareadores dentais


Uma mestranda de odontologia que não conheço pediu por e-mail que eu lhe desse uma “pequena ajuda” em seu trabalho: responder à famosa questão “qual deve ser o tamanho da amostra?” Lembrei a ela de que não seria difícil calcular esse tamanho, se me fossem dadas algumas informações que começariam, evidentemente, com o propósito do trabalho. Depois de algumas idas e vindas, chegamos ao texto abaixo, editado por mim, que sou professora de estatística (e desconheço o jargão da área de odontologia).


Para comparar a efetividade de dois métodos indicados para clareamento dental, será feito um ensaio clínico usando dois grupos de pacientes: um grupo será submetido a um novo método, mas já testado, que chamaremos de N. O outro grupo será submetido a um método convencional, que chamaremos de C. Supõe-se que esses métodos possam ter efetividade diferente. O desfecho será uma variável dicotômica, isto é, sim ou não para cada participante da pesquisa, indicando se houve ou não clareamento nos dentes. A avaliação será feita por profissional, fazendo uma observação no início e outra após o clareamento. Serão submetidos a essa avaliação n pacientes que passarem pelos critérios de elegibilidade e que serão designados para o método A ou para o método B por processo aleatório.


Informei à mestranda que existe uma fórmula para calcular o tamanho de uma amostra para comparar dois métodos quando a variável é dicotômica. E expliquei mais claramente:


Para comparar duas proporções, o tamanho da amostra para cada grupo (n) é dado por:


em que

n é o tamanho de cada grupo, sendo os grupos de igual tamanho

Z = valor de Z correspondente ao nível de confiança desejado (por exemplo, 1,96 para 95% de confiança)

p1 = proporção estimada para o novo método (N)

p1 = proporção estimada para o método convencional (C)

 = diferença mínima detectável entre proporções


A resposta chegou em tom irritado: “eu não quero fórmulas de livros, quero a resposta para o meu problema”. Então perguntei: “qual seria a porcentagem de pessoas em que você espera “ver” clareamento quando usar o método C? E no método N?” E a resposta foi aquela que já ouvi muitas vezes, em se tratando de calcular tamanho de amostras: “se eu soubesse, não faria a pesquisa”. Pois é, e a literatura da área?


Mas nessa situação, ou se improvisa ou não se responde. Então, improvisei: considerei o nível de confiança mais comum nos trabalhos publicados: 95%. E os valores de p1 e p2? Como nenhuma estimativa específica estava disponível, considerei que as duas proporções deveriam ser maiores que 0,5. Um palpite, pouco otimista para um dentista clínico como a mestranda, mas que mesmo assim sugeri: p1 = 0,7 e p2 = 0,6 e, portanto, d = ∣p1− p2∣ = 0,1 seria a diferença esperada entre as proporções Fazendo os cálculos:


• p1=0,7 (novo tratamento)

• p2=0,6 (convencional)

• d=0,1

• Z=1,96


De acordo com os cálculos feitos, são necessários cerca de 173 participantes por grupo para detectar uma diferença de 10% com 95% de confiança, quando se pressupõe proporções como 0,7 e 0,6. Obviamente, esta proposta foi rejeitada. Não se faz um ensaio clínico, para uma tese de mestrado, com cerca de 350 participantes. E a orientadora achou que as pressuposições feitas, p1 = 0,7 e p2 = 0,6, estavam absurdamente abaixo das expectativas ou mesmo realidade.


Procurei então alguma informação para a taxa de sucesso de clareamento dentário. Achei, em um site americano1 a seguinte frase: “Generally, tooth whitening is successful in at least 90 percent of patients.” Não é irrealista supor que o tratamento convencional tenha uma taxa de sucesso de 0,9, especialmente se for um tratamento bem estabelecido e eficaz. Aliás, ensaios clínicos são projetados para melhorar tratamentos que já têm altas taxas de sucesso. No entanto, quando a taxa de sucesso da linha de base é muito alta, detectar melhorias requer tamanhos de amostra maiores porque a margem para melhoria é muito pequena. Mas veja os cálculos para p1 = 0,95 e p2 = 0,90.

• p1 =0,95 (novo tratamento)
• p2=0,90 (convencional)
• d=0,05
• Z=1,96


De acordo com os cálculos feitos, são necessários cerca de 212 participantes por grupo para detectar uma diferença de 5% com 95% de confiança, quando se pressupõe proporções como 0,95 e 0,90.


Mas a mestranda me informou que sua orientadora dispensou minhas considerações. Como o desperdício sempre me aborrece, não vou jogar no lixo o que fiz. Talvez alguém aproveite. De qualquer forma, não há como caber no orçamento de mestrado a coleta de uma amostra para detectar diferenças muito pequenas entre dois tratamentos com altas taxas de sucesso.


Importante: não foi estipulado aqui o valor do poder do teste. 


Referência

                              1.     The risks of teeth whitening - Delta Dental

                          https://www.deltadentalins.com/.../bleaching_risks.ht...

                      Veja algumas calculadoras para tamanho de amostras:


Sunday, March 20, 2016

NNH número necessário para causar dano em ensaios clínicos

A ANVISA recomenda que, na descrição dos resultados de um ensaio clínico, seja apresentada uma estimativa do número necessário para causar dano (NNH — Number Needed to Harm), acompanhada do respectivo intervalo de confiança, para cada intervenção avaliada.

     ⚠️  O que é o NNH?

NNH representa o número de pacientes, com determinada patologia e em determinadas condições, que devem ser tratados até que um deles experimente um desfecho adverso — como, por exemplo, uma complicação terapêutica1.

Por exemplo, se para determinada condição clínica, uma droga apresenta NNH = 100, isso significa que, em média, 100 pacientes devem ser tratados (em vez de permanecerem no grupo controle) para que se observe um caso adicional de complicação.

    ⚠️ Como calcular o NNH?

O cálculo do NNH baseia-se na diferença de riscos entre o grupo tratado e o grupo controle:

                      🔸  rt ​ = proporção de danos no grupo tratado

                     🔸  rc ​ = proporção de danos no grupo controle

A fórmula2 para o cálculo é:

  ​

Exemplo prático

Considere um ensaio clínico randomizado realizado para avaliar se uma nova intervenção aumenta o risco de óbito após o diagnóstico de câncer de pulmão em estágio III. No estudo, 450 pacientes foram randomizados: 250 para o grupo controle e 200 para o grupo de intervenção. Durante o período de acompanhamento, registraram-se os resultados apresentados na tabela.

Aplicando a fórmula:

O valor de NNH = 8,3 indica que, em média, seria necessário tratar aproximadamente 8 pacientes com a nova intervenção (em vez de deixá-los no grupo controle) para que ocorresse um óbito adicional no período analisado.

 ⚠️   NNH, NNT e avaliação risco-benefício

A comparação entre o número necessário para tratar (NNT) e o número necessário para causar dano (NNH) fornece uma visão do balanço risco-benefício de uma intervenção:

                     🔸     Quanto menor o NNT, maior o número de pacientes que se beneficiam.

                   🔸    Quanto maior o NNH, menor o número de pacientes que experimentam  eventos adversos.

⚠️  Intervalos de confiança para o NNH

Tanto o NNT quanto o NNH são estimativas pontuais e, como toda estimativa, possuem uma margem de incerteza. Essa incerteza é usualmente expressa por um intervalo de confiança (IC).

Por exemplo, um intervalo de 95% de confiança para o NNH indica que, se o estudo fosse repetido 20 vezes sob as mesmas condições, o verdadeiro valor do NNH seria esperado dentro do intervalo obtido em 19 dessas repetições.

Quanto maior o número de pacientes estudados, mais estreitos serão os intervalos de confiança das estimativas, aumentando a precisão dos resultados. Para os cálculos dos intervalos de confiança, recomenda-se o uso de softwares estatísticos especializados ou calculadoras on line3.

Referências

1.  Straus, S. E.; Glasziou, P.; Richardson, W.S.; Haynes ,R.B.  Evidence-Based Medicine Rio de janeiro. Elsevier 2018.

2.     Number Needed to Treat (NNT) Calculator - ClinCalc clincalc.com/Stats/NNT.aspx

3. Smart Health Choices. Making Sense of Health Advice. https://www.ncbi.nlm.nih.gov/books/NBK63638/